L’évolution rapide des agents d’intelligence artificielle a introduit une nouvelle dimension dans notre rapport à la technologie : l’action. Aujourd’hui, les IA ne se contentent plus de générer du texte. Elles utilisent des « skills » (compétences tierces) pour exécuter du code, lire des fichiers locaux et interagir directement avec nos environnements informatiques.
Qu’est-ce qu’un « Skill » d’Agent IA ?
Un skill (ou compétence) est un outil externe ou un plugin qui permet à un agent IA de se connecter au monde réel pour récupérer du contexte ou effectuer une tâche. Aujourd’hui, le standard de référence pour ces compétences est le Model Context Protocol (MCP). Il s’agit d’un protocole open-source qui permet d’intégrer de manière transparente et sécurisée les LLM avec des sources de données et des outils externes (comme GitHub, Slack, des bases de données ou votre système de fichiers).
Bien que cette capacité d’action décuple la productivité, elle ouvre également la porte à des failles de sécurité critiques.
Les 3 Menaces Principales liées aux Agents IA
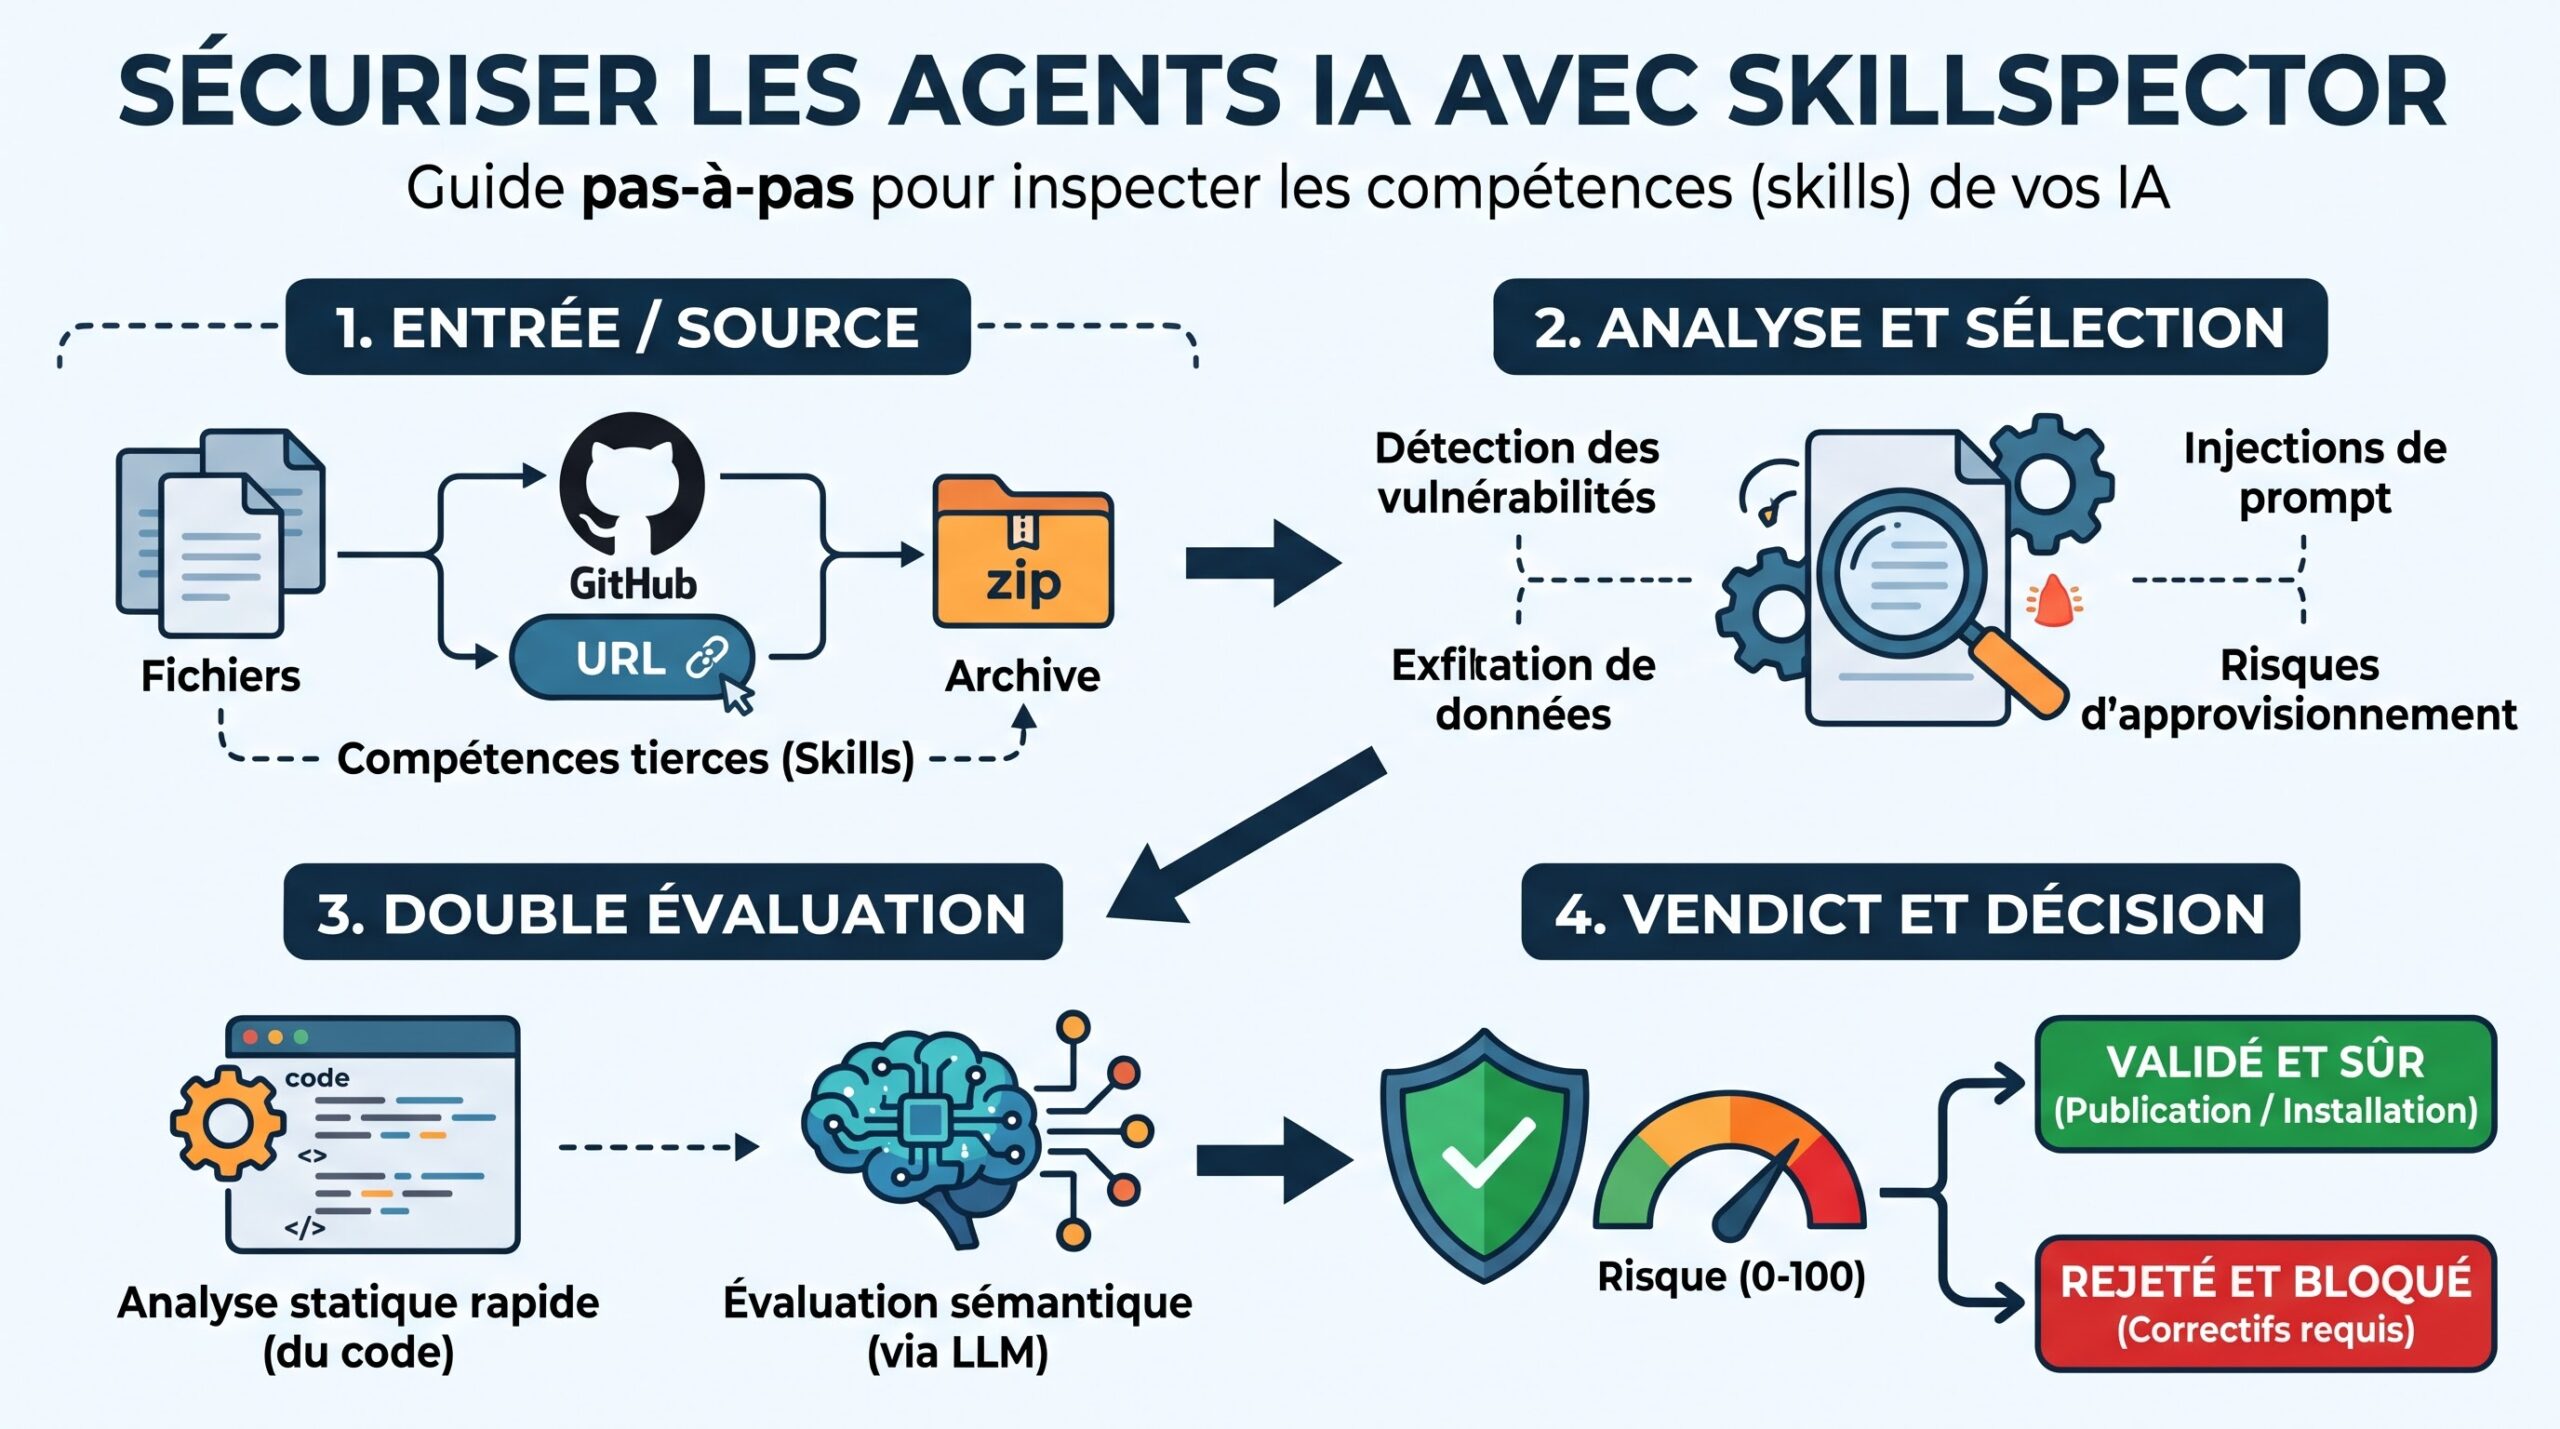
- 1. L’Injection de Prompt et le Détournement d’Objectif : Les agents IA sont pilotés par le langage naturel. Un attaquant peut dissimuler des instructions malveillantes (injections de prompt) dans une page web ou un document que l’IA est chargée d’analyser. L’agent, trompé, pourrait être forcé d’exécuter des actions dangereuses à l’insu de l’utilisateur.
- 2. L’Agence Excessive et l’Exfiltration de Données : Lorsqu’un skill mal configuré ou malveillant est activé, il peut profiter des privilèges accordés à l’IA pour fouiller dans votre environnement local. Le risque majeur est l’exfiltration discrète de données sensibles (clés d’API, code source privé) vers des serveurs externes.
- 3. Le Piège de la Chaîne d’Approvisionnement (Supply Chain) : Installer aveuglément un serveur MCP ou une compétence développée par un tiers expose l’utilisateur à un risque de la chaîne d’approvisionnement. Un outil non vérifié peut contenir des vulnérabilités ou des portes dérobées (backdoors), transformant votre assistant IA en cheval de Troie.
Analyser et Sécuriser : L’approche NVIDIA SkillSpector
Pour contrer ces menaces liées à l’installation d’outils tiers, NVIDIA SkillSpector propose une solution préventive. Il s’agit d’un outil de sécurité open-source conçu pour scanner les skills d’agents IA (comme les serveurs MCP ou les outils Claude Code) avant de les installer. En combinant une analyse statique classique et une évaluation sémantique gérée par un LLM, SkillSpector détecte les vulnérabilités, les tentatives d’exfiltration et les fuites de prompt, attribuant ainsi un score de risque objectif pour aider les développeurs à auditer ce qu’ils font entrer sur leur machine.
Alternatives et Outils de Sécurité IA (Red Teaming)
Si SkillSpector se concentre spécifiquement sur l’inspection des skills avant installation, d’autres solutions open-source permettent de tester la robustesse globale des modèles et de leurs environnements (ce qu’on appelle le Red Teaming) :
- Garak (Generative AI Red-teaming & Assessment Kit) : Également soutenu par NVIDIA, Garak est un scanner de vulnérabilités open-source agnostique. Il sonde activement les LLM pour détecter les hallucinations, les fuites de données, le code malveillant et les faiblesses face aux injections de prompt.
- PyRIT (Python Risk Identification Tool pour Generative AI) : Développé par Microsoft, c’est un framework d’automatisation open-source conçu pour aider les équipes de sécurité à identifier les risques liés au comportement et au contenu généré par les systèmes d’IA.
Bases de Connaissances Incontournables
Pour structurer la sécurité de vos applications IA et rédiger vos propres politiques de sécurité, deux référentiels font aujourd’hui autorité et sont indispensables pour toute équipe technique :
- OWASP Top 10 for LLMs : Déclinaison du célèbre standard de l’OWASP, ce projet cartographie de manière claire les 10 vulnérabilités les plus critiques spécifiques aux applications basées sur les LLM (comme le Prompt Injection classé #1, la fuite d’informations sensibles ou l’Agence Excessive). C’est le guide pratique de référence pour les développeurs.
- MITRE ATLAS (Adversarial Threat Landscape for AI Systems) : Calquée sur le framework ATT&CK, cette base de connaissances se place du point de vue de l’attaquant. Elle documente les tactiques et techniques réelles (avec des études de cas) utilisées pour compromettre des systèmes d’intelligence artificielle. Elle est particulièrement utile pour les équipes « Blue Team » et la définition de règles de détection.
Cet article t'a été utile ? Le site, ONDE et Risky restent gratuits et sans pub grâce aux lecteurs. Un café ou un partage : les deux comptent.
